音频怎么翻译成中文?
音频翻译成中文,只要把录音上传到音频翻译工具,选好原语言和中文,再决定只要翻译字幕,还是字幕加 AI 配音。工具会先识别语音、再翻译,选了配音还会用新的声音读出译文。下载之后,先核对人名和数字再用。
整个流程一句话就能说完。下面要讲的是上传和下载之间到底发生了什么、字幕和配音怎么选,以及在别人听到成品之前,哪些错最值得先揪出来。
音频翻译背后其实是三道工序
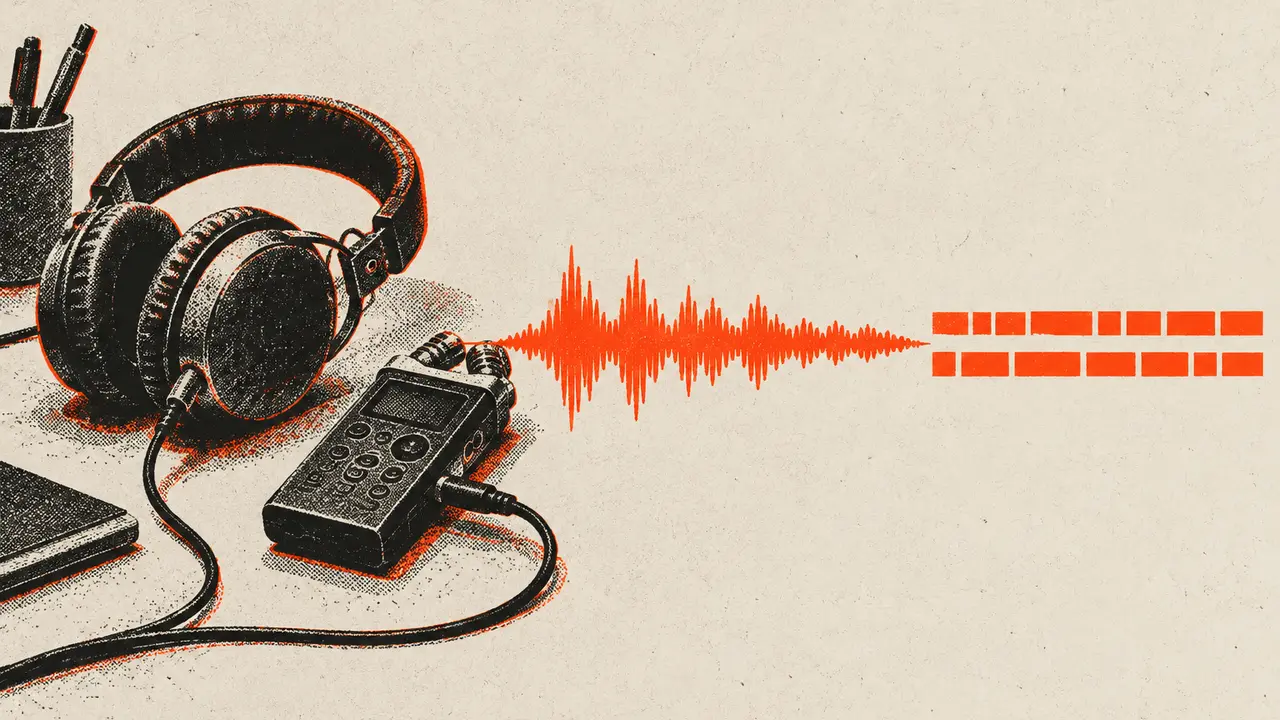
音频翻译不是一个模型干一件事,而是一条三段的流水线,每一段的输出都是下一段的输入。
第一段是语音识别:软件把录音「听写」下来,并打上时间戳,这就是原文字幕。第二段是翻译:把这些字幕逐句翻成目标语言,同时参考上下文,保证句子连贯。第三段是可选的语音合成:让 AI 声音把译文读出来,最后得到一条目标语言的新音轨。
这条流水线带来一个很关键的后果:错误会往下游传。识别阶段把一个产品名听错了,翻译就会忠实地翻出那个错词,配音再字正腔圆地念出来。翻译修不好一个从一开始就没被识别对的词。所以录音本身的质量,往往比大多数人以为的更重要;交付前的检查,也要盯住识别最容易出错的地方。
这也是为什么就算你只关心译文,原文字幕依然有用。某一句译文看着别扭时,拿它和识别出的原文一对,马上就能判断问题出在识别还是出在翻译。
只要字幕,还是要 AI 配音?
大多数音频翻译工具给的都是同一个选择:翻译完就停,只拿文字;或者再往前走一步,生成译文的配音。两者没有绝对的好坏,服务的是不同的受众。
| 只要翻译字幕 | 字幕 + AI 配音 | |
|---|---|---|
| 拿到什么 | 翻译后的字幕文件 | 目标语言音频 + 原文字幕 + 翻译字幕 |
| 适合场景 | 对照阅读、整理纪要、摘抄引用、自己发字幕 | 需要「听」而不是「看」的人,比如播客听众、培训音频 |
| 工作量 | 流水线更短,要检查的东西更少 | 多一道工序,还要听语速和发音 |
| 改完文字之后 | 修改只更新字幕 | 可以重新配音,让声音和改后的文字一致 |
| 计费逻辑 | 按音频时长 | 同样按音频时长;改完重新配音会额外消耗额度 |
一个简单的判断法:译文是拿来看、摘抄或贴到别处的,字幕就够了;需要有人听的,比如想把一段英文访谈分享给不看英文的同事,或者把外语语音留言转成中文播给家人听,就打开配音。
拿不准的话,先从字幕开始。读一遍翻译字幕,是判断「这段录音和译文值不值得再配音」最快的办法。
录音翻译前,先把素材准备好
动手前花几分钟准备,通常比事后改半天更省事。
格式要对。 Belin Doc 的音频翻译支持 MP3、WAV、M4A、AAC、FLAC 五种格式。OGG、Opus、WMA、AMR 不支持,需要先转成上面任意一种。手机录音常见的 M4A 可以直接传;微信语音、部分录音笔导出的 AMR 之类,用常见的免费音频转换工具导成 MP3 或 WAV 即可。
人声要清楚。 语音识别通常在「一次一个人说话、离麦克风近、没有大声背景音乐」的条件下表现最好。多人抢话的会议录音、背景音乐压着人声的片段,一般识别错误会更多。如果同一段内容有更干净的版本,优先用那个。
把用不上的剪掉。 开头的长时间静音、正式开始前的闲聊、十分钟的调试杂音,都会和正文一样被处理、被计费。上传前剪掉,成品更短、更好检查,也更省额度。
太长的录音可以拆开。 一场三小时的讲座分段检查会轻松很多;某一段音质特别差,也能单独处理。工具每个任务只收一个文件,拆开之后还可以先翻最重要的那几段。
弄清楚录音里说的是什么语言。 选对原语言能帮识别一把。如果录音里夹杂两种语言,另一种语言的部分要多花点时间核对。
交付前要检查的四件事
语音的自动翻译,把大意传达到位通常不成问题;它出错的地方却很有规律,针对性地查一遍就能拦下大部分问题。
先查人名和专业术语。 人名、公司名、产品名和行业黑话,是识别模型最没「听过」的词,常被替换成读音相近的常用词。你知道一定会出现的名字,逐个在翻译字幕里搜一遍。
再查数字。 价格、日期、百分比、数量,既容易听错也容易翻错,而一个错数字造成的麻烦,远比一句略显生硬的话大。每个数字都和原文字幕对一下。
然后看时间轴和每行长度。 译文和原文的长度往往不一样,一句翻长了,那行字幕在屏幕上停留的时间就可能不够看完。打算公开发布字幕的话,对着音频完整放一遍。
选了配音的,至少完整听一遍译文音频,重点听人名的读法、语速是否自然。要注意:你改了字幕里的一句话,配音音轨不会自己跟着变。在 Belin Doc 上,任务完成后可以编辑翻译字幕,再重新生成配音,让声音和修改后的文字对上。重新配音会额外消耗额度,所以最好把所有修改攒到一起,一次性重配。
音频翻译、视频翻译和实时语音翻译 App 有什么区别
这三类工具搜索时用的词很像,干的却是不同的活。
实时语音翻译 App 是为对话设计的:你对着手机说一两句,它翻出来,对方再回话。它追求的是快,不是产出文件,一般也不会给你带时间轴的字幕或完整的配音音轨。
音频文件翻译工具面向的是你手里已有的录音:播客、采访、课程、语音备忘录、会议录音。它处理整个文件,给出可编辑的带时间轴字幕,还能生成完整的配音音轨。成品需要保存、审校或分享时,选它就对了。
视频翻译对视频文件做同样的事,额外还要让字幕和配音跟画面同步。如果手里是 MP4 之类的视频,直接用视频翻译,不必自己先把音频抽出来;具体流程可以看这篇在线视频翻译指南。只有声音、没有画面可看的录音,直接用音频翻译即可。
在 Belin Doc 上把音频翻译成中文的步骤
第一步:上传音频文件
打开音频翻译页面,上传一个 MP3、WAV、M4A、AAC 或 FLAC 文件。每个任务只收一个文件,多段录音请分别提交。在首页的「文档」或「视频」标签里拖入音频文件,也会自动转到音频翻译。
第二步:选择语言和是否配音
设置录音里说的语言,以及想要的目标语言,比如中文。然后选一个 AI 配音音色,或者选择不配音、只要翻译字幕。上传完成后,页面会马上按音频时长显示预估消耗的额度,实际扣费在提交时进行。
第三步:提交并查看进度
提交任务后,在音频翻译页的「最近任务」里查看进度,这个列表和视频任务是分开的。语音识别、字幕翻译,以及(如果选了的话)配音会依次完成。
第四步:审校、修改并下载
任务完成后,检查翻译字幕里的人名、术语和数字,有错就改。开了配音的,改完可以重新配音,让声音跟上修改。最后下载目标语言音频和原文、翻译两份字幕;没开配音的,下载翻译字幕即可。
常见问题(FAQ)
音频翻译支持哪些格式?
支持 MP3、WAV、M4A、AAC、FLAC。OGG、Opus、WMA、AMR 不支持,上传前请先转成上述任意一种格式。
录音翻译怎么收费?
按音频时长从账户的翻译额度里扣。上传后马上能看到预估额度,实际扣费发生在提交时。
翻译完能拿到哪些文件?
开了配音:目标语言音频、原文字幕、翻译字幕。没开配音:只有翻译字幕。
译文能修改后重新配音吗?
可以。任务完成后可以编辑翻译字幕,再重新生成配音,重新配音会额外消耗额度。没开配音的任务,修改只会更新字幕。
可以一次翻译多个音频文件吗?
每个任务只收一个文件,多段录音请分别提交。时长上限和可同时进行的任务数与视频翻译的规则相同,而且音频和视频任务合并计算。
音频翻译和视频翻译该用哪个?
播客、采访、语音备忘录这类只有声音的录音,用音频翻译;视频文件用视频翻译,这样字幕和配音才能跟画面同步。